

2025年04月10日
2026年10月15日配信
Chat GPTのようなLLM(大規模言語モデル)を利用したチャット型の文章生成AIの普及に伴い、ハルシネーション(事実と異なる出力)の問題も指摘されています。この問題の解決策として、生成AIに適切な情報を参照させることで回答の精度を上げる、「RAG(Retrieval-Augmented Generation)=検索拡張生成」というフレームワークが注目を集めています。
ハルシネーション(hallucination)とは「幻覚」の意味ですが、文章生成AIが時に「事実でないことを本当のように語る現象」も指すようになりました。この原因は、LLMに基づく文章生成AIは、言葉の意味を理解して文章を作るのではなく、次の単語を推測することで文章を紡いでいく点にあります。結果、回答が文脈重視になる傾向があり、不正確な情報源を参照して、文脈に則した「それっぽい回答」を出してしまうケースが散見されるようになったのです。
生成AIは自然で説得力のある文章を作れますが、時に誤りや創作が含まれるハルシネーションと呼ばれる現象を起こします。このハルシネーションを、外部情報を参照することで軽減する対策がRAGなのです。
RAG(検索拡張生成)は、LLM(大規模言語モデル)の情報源に外部データ検索を組み合わせることで、文章生成AIに最適な情報をもとにした回答をアウトプットさせる手法。精度や信頼性を向上させる手法を指します。
RAG(Retrieval Augmented Generation)は、大きく分けて「検索(Retrieval)」と「生成(Generation)」の2つのステップで構成されています。
まず自然言語(人が通常使う言葉)で問いかけを入力すると、「検索」ステップでは、目的や用途に応じたデータ(社内文書や過去事例の記録など)から、関連する情報を検索します。問いかけ内のキーワードや文脈を手がかりとして、データ中の関連情報を特定し抽出します。
「生成」ステップでは、検索のステップで厳選された関連情報を参照先として、回答となる文章を生成して出力します。
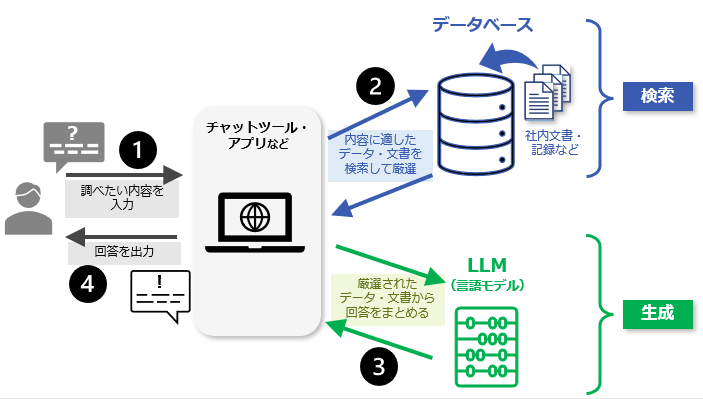
RAGは、文章生成AIの出力を補い、強化することを目的としたフレームワークです。RAGの仕組みは、文章生成AIの自然言語処理の出力に、企業保有のデータなど確実性の高い関連情報を組み合わせて、出力の適切性や信頼性を高めるというものです。このように、適切なデータと文章生成AIを組み合わせたRAGがシナジー効果を生み、様々な分野で知的生産性の向上をもたらすことが期待されています。
文章生成AIとRAGとの関係性は、例えるなら「持ち込み不可の試験(=文章生成AI)」と「持ち込み可の試験(=RAG)」といったところ。文章生成AIは、モデルが学習済みの内容から回答を生成、つまり「あらかじめ学習した知識だけ」で試験を受けるイメージ。つまり「持ち込み不可」の試験です。対して、適切な情報源を参照して回答を生成するRAGは、あらかじめ学習した知識にプラスして、教科書を見ながら回答できる「持ち込み可の試験」のイメージです。
RAGの回答精度向上には、「検索」ステップでの工夫が特に重要になります。情報源となるデータの質が出力精度を直接左右するのはもちろん、質問の文脈から関連情報を的確に検索するためのアルゴリズムが、非常に重要なのです。
製造業のように多様な人が関わる現場では、業務上の技術や技能の属人化が課題です。設備故障データや製品不良データ・報告書などが適切に揃い、トラブルが発生してもすぐ解決できることが理想ですが、そうしたデータやドキュメント類は、往々にして未整理な状態です。
KIBIT Libria(キビット・リブリア)は、社内に散在する非構造ドキュメントを検索・分析可能な状態に整備するドキュメント活用ソリューションです。
社員教育や技能伝承にも使えるRAG基盤を構築するのが特長です。ユーザーが投入したデータのみを学習対象とするため、特定領域に特化したナレッジベースが構築可能です。
FRONTEOが自社開発した自然言語処理AI「KIBIT」により、キーワードの一致に依存しない類似文書検索と、検索結果の根拠となる文書・該当箇所の明示を行います。専門用語や固有表現を含む分野でも、高精度な情報探索と判断支援を実現します。
KIBIT Libriaは、大量のデータから必要な情報を的確に取り出すことができ、取り出した情報の要約が必要な場合は生成AIで要約を出力するというRAGのスキームによって、LLMのみよりも高精度な応答を生成できます。LLMを再カスタマイズする従来の手法よりも、はるかにシンプルかつ確実に精度を上げられます。
表記も形式もばらばらな数十年分の未整理データでも、KIBITによる概念検索は業務用語や表記ゆれもクリアできるため、目的の資料や回答の絞り込みも、適切な情報の特定も対応可能です。その結果、正確な回答や参照先に素早くたどり着けるのはもちろん、使用を重ねることで質問力や問題解決力が向上し、一人ひとりが「わかる、応用できる」組織づくりへつながります。そうした自社データの最適な活用が、現場のリードタイムの短縮、そして知見を常に共有できる組織変革にもつながっていきます。